synthdocs en code source ouvert: des données d'entraînement OCR pour les documents laids
55 595 pages synthétiques de 9 secteurs réglementés, en anglais et en français canadien, télécopiées, numérisées, froissées et tachées de café exprès. Gratuites sous CC BY 4.0.
Les documents que nos clients nous envoient ne sont pas des PDF propres. Ce sont des certificats d'assurance passés deux fois au télécopieur, des factures photographiées sur un bureau, des baux restés pliés une semaine dans une poche et des rapports de laboratoire avec une tache de café. La moitié sont en français.
Les jeux de données OCR publics ressemblent rarement à ça. Ce sont surtout des articles scientifiques, des reçus et des numérisations propres, en anglais. Un modèle entraîné sur ces données lit bien un article de recherche, et mal la troisième photocopie d'un connaissement.
Nous avons donc créé nos propres données d'entraînement. Aujourd'hui, nous en publions une partie: synthdocs, gratuit sous licence CC BY 4.0.
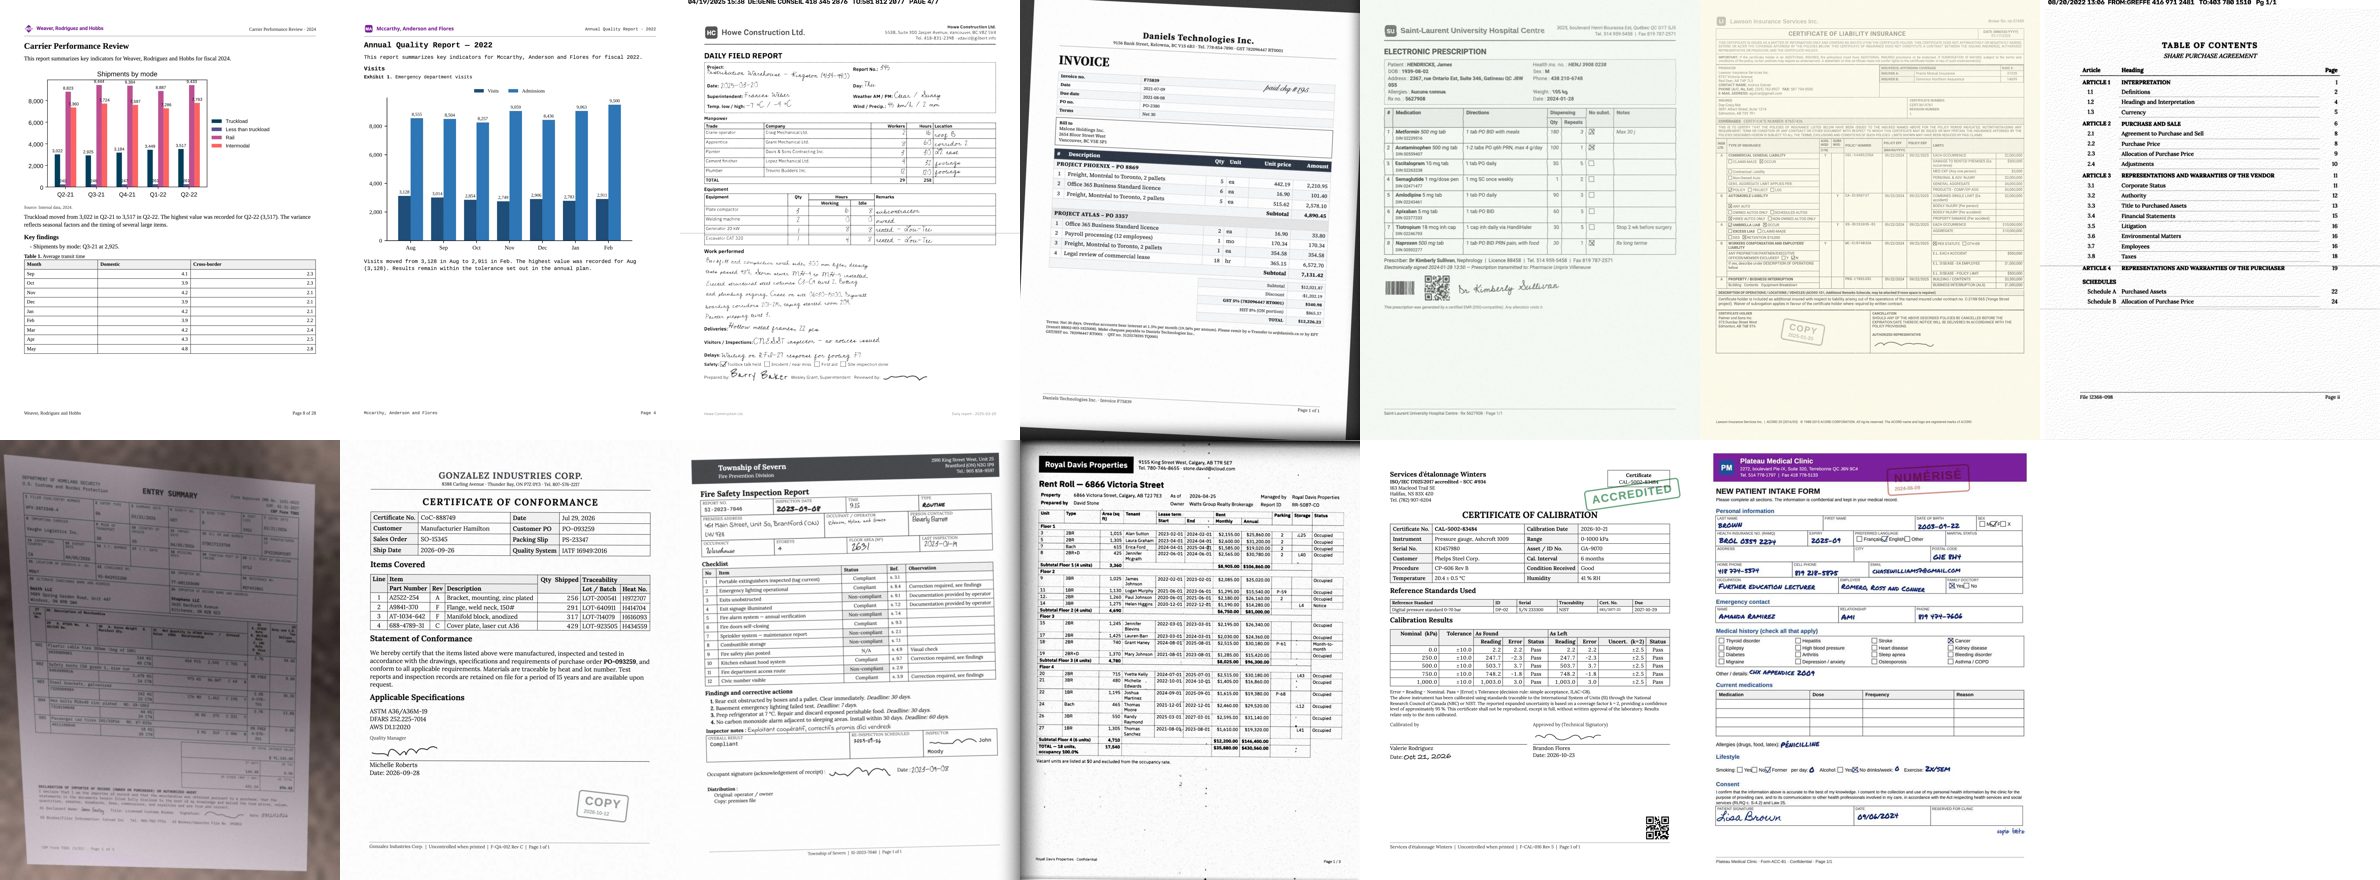
Ce qu'il contient
- 55 595 pages de 9 secteurs réglementés: assurance, santé, juridique, services financiers, immobilier, secteur public, fabrication, construction et logistique.
- 80 types de documents, des déclarations de sinistre et résumés de congé aux renonciations d'hypothèque légale, états locatifs et déclarations en douane.
- Environ 30 % en français canadien. 37 907 pages en anglais et 17 688 en français, et certaines pages en anglais ont des libellés bilingues.
- 17 types de dommages réels. Numérisations à plat, numérisations de travers, télécopies 1 bit et tramées, photos au téléphone, photos floues, photocopies de troisième génération, papier froissé, encre qui transparaît du verso, taches de café, impression matricielle, papier thermique délavé et photos d'écran avec moiré. Environ 4 000 pages restent propres.
Les pages sont réparties en trois sous-ensembles. core compte 49 995 pages, avec les 80 types de documents et les 17 types de dommages. charts ajoute 2 300 pages de rapports avec des graphiques à barres, linéaires et circulaires. styles ajoute 3 300 pages aux polices, couleurs et mises en page variées.
Une vérité terrain exacte
Chaque page est générée, donc chaque annotation est exacte. Chaque page est accompagnée d'un fichier JSON qui contient:
- la page complète en markdown, dans l'ordre de lecture
- les boîtes de mise en page pour 16 catégories de régions, comme les en-têtes, paragraphes, tableaux, champs de formulaire et signatures
- le markdown de chaque région
- chaque tableau en OTSL, HTML et markdown, cellules fusionnées comprises
Le jeu de données sert donc à entraîner des modèles page vers markdown, la détection de mise en page, la reconnaissance de la structure des tableaux et l'OCR en français sur des documents d'affaires canadiens. Un manifeste liste chaque page avec son secteur, son type de document, sa langue et son type de dommage. Vous pouvez ainsi choisir, par exemple, seulement les pages télécopiées en français avant de télécharger quoi que ce soit.
Comment il entraîne rakedoc-nano
synthdocs est un sous-ensemble des données que nous utilisons pour entraîner nos modèles d'analyse de documents, dont rakedoc-nano. Ce modèle renvoie une boîte englobante pour chaque élément produit, texte compris. Il ne peut le faire que parce que les données d'entraînement ont une boîte pour chaque région.
Les dommages comptent autant que les boîtes. Un analyseur qui n'a vu que des pages propres échoue sur une télécopie, et dans les secteurs réglementés, beaucoup de documents arrivent encore par télécopieur.
Limites
Toutes les pages sont synthétiques. Le texte, les nombres et les mises en page ont l'air réels, mais ils sont générés. Les noms, adresses, numéros de téléphone et numéros de compte sont fictifs et suivent les formats canadiens. Chaque page est une seule page format lettre US, et il n'y a pas de documents de plusieurs pages. Les graphiques ont une boîte, mais pas de transcription. Évaluez un modèle sur de vrais documents avant de le mettre en production.
L'obtenir
Le dépôt contient la documentation, le manifeste, le schéma et des pages d'exemple. Les images sont dans des archives tar sur la version v1.0, une par secteur, environ 12 Go au total. Vous pouvez télécharger un secteur ou tous:
scripts/download.sh data core-legal core-healthcare charts
Vous pouvez utiliser, partager et modifier les données, aussi à des fins commerciales, à condition de citer CloudRaker. Si vous préférez ne pas entraîner d'analyseur vous-même, rakedoc-nano est déjà entraîné sur ces données. Ses poids sont sur Hugging Face, et il fonctionne derrière Parse dans l'API CloudRaker.
Foire aux questions
Oui. Il est sous licence CC BY 4.0: vous pouvez l'utiliser, le partager et le modifier à toutes fins, commerciales comprises, à condition de citer CloudRaker.
Non. synthdocs est un sous-ensemble des données d'entraînement que nous utilisons pour nos modèles d'analyse de documents.
Non. Chaque page est synthétique. Les noms, adresses, numéros de téléphone, courriels, numéros de compte et noms d'entreprises sont tous fictifs.
Environ 12 Go, répartis en une archive par secteur, plus une pour les graphiques et une pour les styles. Vous pouvez télécharger seulement les archives dont vous avez besoin.